Second Brain Sub-10ms: Memori Permanen & AST LSP
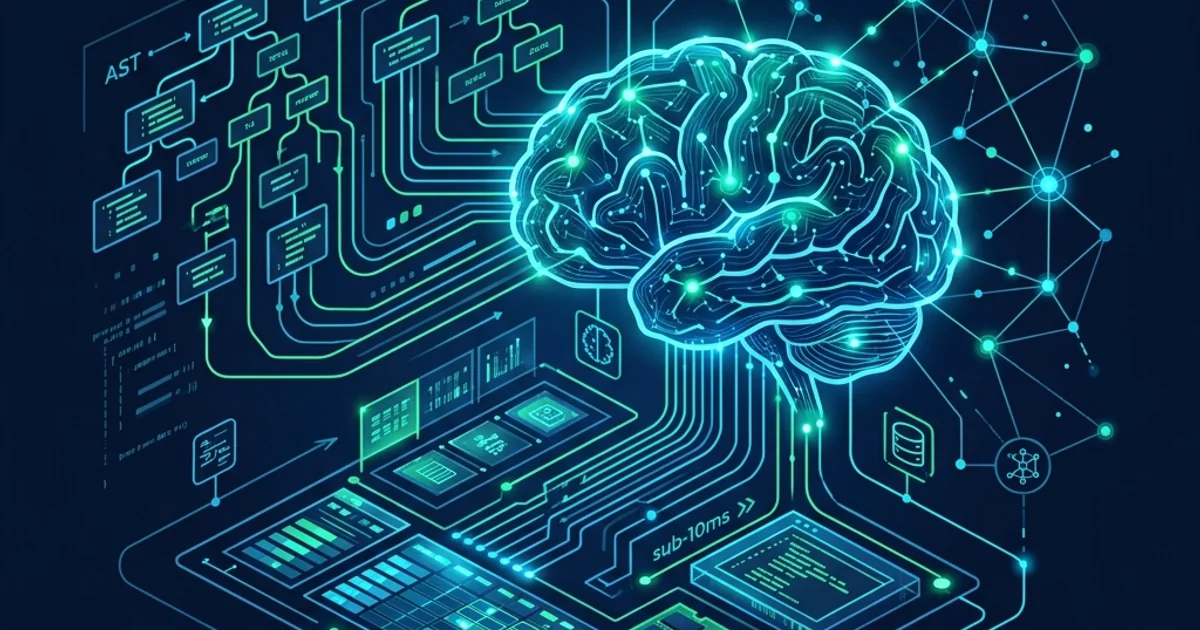
Agen lupa keputusan arsitektur tiap sesi? Bedah Second Brain sub-10ms SQLite WAL FTS5 trigram dan LSP AST jump-to-definition di ACS Core.
Daftar Isi
Lo jelasin arsitektur auth ke agen pagi ini. Tanpa arsitektur second brain yang terintegrasi, sesi baru dibuka dan agen nanya lagi dari awal: "Mau pakai JWT atau session cookie?" Lo ngetik ulang penjelasan yang sama, dan besok pagi agen mengusulkan pola yang bertentangan dengan keputusan kemarin.
Bukan agennya bodoh. Memang tidak ada yang menyimpan keputusan itu di tempat yang bisa dibaca sesi berikutnya.
Mengapa Second Brain dan AST LSP Jauh Mengungguli Grep
Cara paling umum mencari kode: grep -r "handleAuth" . lalu baca hasil satu per satu. Masalahnya, grep tidak paham struktur kode. Ia hanya cocokkan teks.
Tiga kegagalan yang terjadi berulang:
- Nama yang sama, arti beda.
getUserdi modul billing dangetUserdi modul auth cocok sama saja, padahal kontraknya berbeda. - Komentar dan string ikut tercocok. Baris komentar yang menyebut nama fungsi muncul sebagai hit, dan lo buka file yang salah.
- Hasil terpotong. Output grep di terminal panjang dipotong di tengah. Lo menyimpulkan dari potongan, bukan dari gambaran utuh.
Yang lebih mahal: agen AI mengarang path file. Ia bilang "saya sudah perbaiki src/services/auth.ts", padahal file itu tidak pernah disentuh. Klaim terdengar meyakinkan karena dibangun dari teks, bukan dari struktur kode yang sebenarnya.
Bedanya mencari teks dan memahami kode
Regex menjawab pertanyaan "di mana string ini muncul". Yang lo butuhkan sebenarnya adalah pertanyaan lain: "simbol ini didefinisikan di mana, siapa yang memakainya, dan tipenya apa".
Pertanyaan kedua butuh parser. Ia butuh pohon sintaks, bukan pencocokan karakter. Di situ AST dan LSP mengambil peran.
The Unfair Advantage: Satu Database, Dua Jalur Presisi
ACS Core menjalankan Sovereign Second Brain™ di atas satu berkas SQLite WAL. Dua kemampuan berbeda duduk di database yang sama, dan keduanya kembali di bawah 10 milidetik.
Jalur pertama, pencarian kode trigram. Setiap file di workspace diindeks sebagai token trigram, bukan sebagai isi berkas. Database menyimpan path, nomor baris, dan token. Nol byte kode sumber ikut tersimpan.
Konsekuensinya praktis: ukuran database tetap kecil walau repo lo besar, dan pencarian tetap cepat karena yang dicari adalah token, bukan isi berkas.
Hasilnya tiga baris konteks per hit, dengan path dan nomor baris yang bisa lo buka langsung. Direktori sampah seperti node_modules/, dist/, dan .git/ otomatis disaring.
Jalur kedua, memori keputusan. Setiap keputusan arsitektur, konvensi tim, dan hasil verifikasi disimpan sebagai entri terstruktur dengan kategori, tag, dan relasi semantik. Entri lama tidak dihapus, ia ditandai superseded dan diganti, jadi rantai keputusan tetap bisa dilacak mundur.
Agen tidak perlu lo ingatkan untuk menyimpan. Setiap tugas yang selesai, keputusan pentingnya masuk ke database lewat jalur sinkronisasi ganda: status kanban dan catatan blueprint.
Recall otomatis, bukan pencarian manual
Bagian yang paling sering diabaikan: agen tidak perlu mencari memori sendiri. Sebelum prompt lo diproses, hook hippocampus menyuntikkan konteks relevan secara otomatis dengan anggaran waktu di bawah setengah milidetik pada cache hit.
Kalau cache kosong atau timeout, hook menyerah dengan anggun. Ia tidak memblokir prompt, tidak memicu reindex, dan tidak menampilkan error ke lo. Agen tetap jalan, hanya tanpa suntikan konteks tambahan.
Efeknya, sesi baru tidak mulai dari nol. Agen tahu keputusan yang sudah diambil minggu lalu, tanpa lo menjelaskan ulang.
LSP AST: navigasi tanpa menebak
Di samping memori, ACS membawa LSP berbasis AST untuk navigasi kode. Bedanya dengan pencarian teks:
jump-to-definitionmelompat ke deklarasi simbol sebenarnya, bukan ke kemunculan pertamanya.hovermenampilkan tipe dan dokumentasi simbol tanpa membuka berkasnya.find-referencesmenemukan seluruh pemakai simbol, termasuk yang lewat import alias.renamemengubah nama simbol lintas berkas tanpa menyentuh komentar atau string literal.
Semua berjalan dari satu biner mandiri, tanpa perlu menghidupkan server bahasa eksternal per bahasa. Tidak ada Node process, tidak ada Python LSP server yang harus lo rawat.
Resep Skema Memori dan Disiplin Recall
Bagian ini berisi susunan tabel database, aturan indeksasi delta, dan urutan pemanggilan tool yang kami pakai di mesin produksi.
Skema Database Second Brain dan Indeks Trigram
Kapan Memori Permanen Benar-Benar Masuk Akal
Kalau lo kerja di repo kecil dengan satu sesi harian, memori permanen terasa seperti kemewahan yang tidak perlu. Itu wajar.
Nilainya muncul saat repo-nya besar, tim-nya beberapa orang, dan sesi agen berjalan berhari-hari. Di situ, satu pencarian sub-10ms menggantikan lima menit membaca hasil grep, dan satu entri keputusan mencegah agen mengusulkan arsitektur yang sudah ditolak kemarin.
Kalau lo ingin melihat bagaimana memori ini duduk bersama suite lain, buka seksi fitur ACS. Di sana ada Sovereign Second Brain, AST Intel, dan Governance Citadel dalam satu paket.
Untuk akses penuh ke skema database dan aturan indeksasi, buka halaman harga. Satu lisensi membuka seluruh resep di artikel ini plus pembaruan engine saat format repo lo berubah. Pelajari standar arsitektur Language Server Protocol di Microsoft LSP Specification ↗.
Artikel Terkait Lainnya
Bedah Arsitektur acs adopt: 15 Detik Deploy 21 Agen
Onboarding repo lama nggak perlu berhari-hari. Satu perintah acs adopt memindai stack, menyuntik 21 persona agen dan 7 refleks otonom dalam 15 detik.
Bypass Cloudflare Turnstile dengan Stealth Browser MCP
Puppeteer polos kena 403 dalam 2 detik. Bedah arsitektur Tri-Engine Stealth Browser MCP untuk bypass Cloudflare Turnstile secara deterministik.
Disiplin TDD RGR Otomatis: Stop Klaim Palsu Kode Selesai
Agen bilang tugas selesai, kode langsung crash. Bedah ilusi false completion dan cara TDD Red-Green-Refactor plus verifier independen menutupnya.
💬 Komentar Komunitas
Diskusi komunitas akan segera dibuka
Komentar untuk “Second Brain Sub-10ms: Memori Permanen & AST LSP” belum aktif pada versi ini. Sementara itu, sapa kami via GitHub.